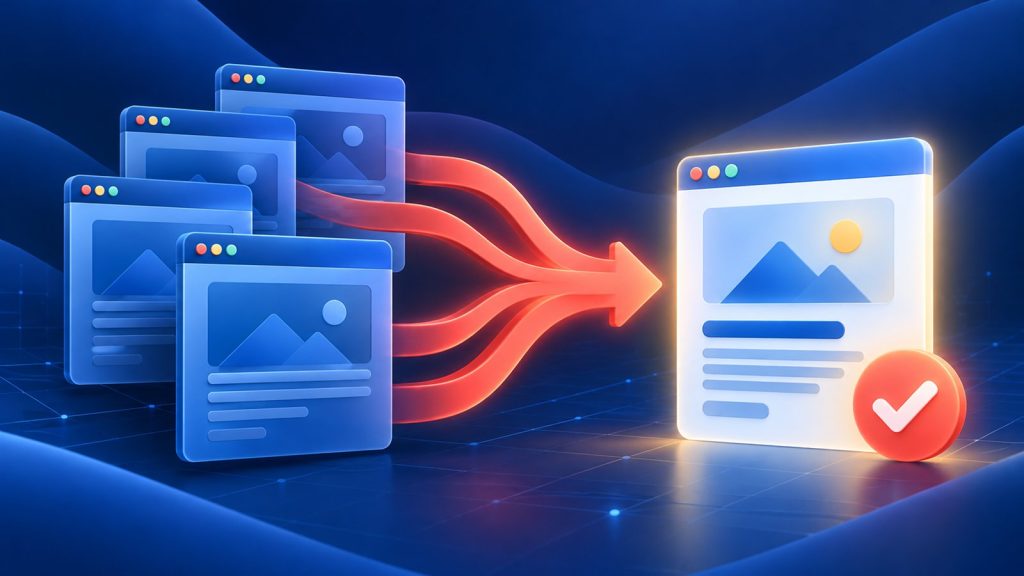
Conteúdo duplicado em SEO existe quando duas ou mais URLs apresentam informação igual ou muito semelhante. É comum em lojas online, sites WordPress, páginas com filtros, versões para impressão e endereços criados por parâmetros de rastreamento.
A duplicação nem sempre representa uma penalização. O problema surge quando os motores de pesquisa não conseguem perceber qual é a versão principal, distribuem os sinais entre vários endereços ou gastam recursos a rastrear páginas sem valor independente.
O que é conteúdo duplicado?
Há conteúdo duplicado quando o mesmo conteúdo principal pode ser acedido através de URLs diferentes. Por exemplo, uma página pode estar disponível com e sem parâmetros, através de HTTP e HTTPS ou em versões com e sem barra final.
O Google agrupa normalmente estas versões e escolhe uma URL canónica, isto é, a página que considera mais representativa. Essa escolha é uma forma de deduplicação. A canonical indicada pelo proprietário do site funciona como um sinal importante, mas o Google pode selecionar outra URL se encontrar sinais contraditórios.
Conteúdo duplicado provoca uma penalização?
Na maioria dos casos, não. A duplicação técnica normal não constitui, por si só, uma violação das políticas de spam. No entanto, pode prejudicar o desempenho orgânico de forma indireta: dificulta a consolidação de autoridade, torna os relatórios menos claros e pode levar o Google a mostrar uma URL diferente daquela que pretendia posicionar.
Copiar conteúdo de outros sites sem acrescentar valor é um problema diferente. Além de criar riscos legais e de credibilidade, raramente oferece motivos para que a página copiada seja preferida nos resultados de pesquisa.
Causas mais frequentes de duplicação
- Parâmetros de filtros, ordenação, campanhas e sessões;
- Versões HTTP, HTTPS, www e sem www acessíveis em simultâneo;
- Páginas de categorias, etiquetas e arquivos com introduções iguais;
- Produtos presentes em várias categorias com URLs diferentes;
- Versões para impressão, PDF ou dispositivos específicos;
- Ambientes de teste ou desenvolvimento abertos aos motores de pesquisa;
- Artigos que respondem à mesma intenção de pesquisa e concorrem entre si.
Como identificar conteúdo duplicado
Comece pelo Google Search Console. Na inspeção de URL, compare o “URL canónico declarado pelo utilizador” com o “URL canónico selecionado pelo Google”. Quando são diferentes, confirme se a escolha do Google faz sentido ou se existem sinais técnicos inconsistentes.
Os relatórios de indexação podem apresentar estados como “Página alternativa com etiqueta canónica adequada” ou “Duplicado, o Google escolheu uma página canónica diferente”. Nem todas estas situações exigem correção. A prioridade deve ser dada a URLs importantes que perderam impressões, ligações ou capacidade de posicionamento.
Uma auditoria SEO também permite comparar títulos, descrições, headings, texto principal, canonicals, códigos de resposta e ligações internas em escala.
Como corrigir conteúdo duplicado
1. Use redirecionamentos quando existe uma única versão válida
Se uma URL deixou de ser necessária, redirecione-a permanentemente para a versão principal. Um redirecionamento 301 é um sinal forte de canonicalização e evita que utilizadores e motores de pesquisa continuem a encontrar uma página obsoleta.
2. Aplique rel=”canonical” em páginas semelhantes
Quando as diferentes versões precisam de continuar acessíveis, a etiqueta rel=”canonical” pode indicar qual deve concentrar os sinais orgânicos. A URL canónica deve responder com código 200, ser indexável e, regra geral, apontar para si própria.
Evite cadeias de canonicals, referências para páginas redirecionadas e combinações em que uma URL aponta como canónica para outra, mas recebe ligações internas e inclusão no sitemap como se fosse a principal.
3. Consolide artigos que disputam a mesma intenção
Dois textos não precisam de ser cópias literais para competir pelo mesmo termo. Quando várias páginas respondem à mesma necessidade, escolha a versão mais útil, incorpore nela a informação relevante e redirecione os endereços que deixaram de ter uma finalidade própria.
Esta consolidação reduz a canibalização e cria uma página mais completa. Se alguma URL desapareceu do índice, consulte também o guia sobre como recuperar páginas desindexadas no Google.
4. Torne consistentes as ligações internas e o sitemap
Ligue internamente apenas para a versão canónica e inclua essa mesma URL no sitemap XML. Misturar variantes envia sinais contraditórios e dificulta a consolidação. O artigo sobre SEO técnico para WordPress explica outras prioridades de rastreamento e indexação.
Canonical, noindex ou robots.txt: qual escolher?
- Redirecionamento 301: utilize quando a versão duplicada não precisa de continuar disponível;
- Canonical: utilize quando várias versões precisam de existir, mas apenas uma deve ser a referência principal;
- Noindex: utilize quando a página deve continuar acessível aos utilizadores, mas não deve aparecer na pesquisa;
- Robots.txt: serve para gerir o rastreamento, não para garantir a remoção de uma URL do índice.
Não bloqueie no robots.txt uma página cuja canonical precisa de ser lida pelo Google. Se o rastreador não conseguir aceder ao conteúdo, também pode não conseguir interpretar os sinais que configurou.
Erros a evitar
- Definir todas as páginas do site como canónicas para a página inicial;
- Usar canonical para esconder conteúdos fracos sem rever a arquitetura;
- Manter no sitemap URLs que redirecionam ou têm noindex;
- Criar páginas quase iguais apenas para variar uma palavra-chave ou localização;
- Corrigir etiquetas técnicas sem atualizar as ligações internas.
Quanto tempo demora o Google a reconhecer a correção?
A consolidação não é imediata. Depois das alterações, o Google precisa de voltar a rastrear e reavaliar as URLs. Em alguns casos, a reorganização do conjunto de páginas duplicadas pode demorar dias ou semanas. Mantenha os sinais consistentes e acompanhe a cobertura, as impressões e a canonical escolhida.
Conclusão
O objetivo não é eliminar todas as páginas semelhantes, mas garantir que cada URL tem uma função clara. Redirecionamentos, canonicals, sitemap e ligações internas devem apontar na mesma direção. Quando a duplicação é editorial, consolidar conteúdos costuma ser mais eficaz do que multiplicar páginas concorrentes.
Uma estratégia de manutenção SEO permite detetar estes conflitos antes de afetarem a visibilidade. Para uma análise adaptada ao seu site, conheça o serviço de consultoria SEO.


Pingback: Canibalização de palavras-chave: como identificar e corrigir - Cloud Marketing